回归与性能
benchmarks/ 位于 tkdeft 仓库根目录下,一身两职:
- 回归套件——回答"这次改动有没有改坏东西";
- 性能基准——回答"到底快了多少",而不是"看起来应该快了"。
所有脚本失败时都以非 0 退出码结束,因此可以直接接进 CI。
生成的图片统一落在 benchmarks/_out/(已加入 .gitignore)。
一键跑完
python benchmarks/run_all.py          # 9 项(含性能基准)
python benchmarks/run_all.py --quick  # 8 项(跳过性能基准)
| 命令 | 项数 | 何时用 |
|---|---|---|
run_all.py --quick |
8 | 日常改完随手跑一遍;几十秒到一两分钟量级 |
run_all.py |
9 | 提交前 / 发版前;多出的一项是性能基准 |
退出码:
| 退出码 | 含义 |
|---|---|
0 |
全部检查通过(末尾打印 全部回归通过(N 项)) |
非 0 |
有检查失败;末尾会列出哪一项、哪个脚本、退出码 |
完整模式里的性能基准怎么跑的
run_all.py 调的是 bench_render.py --repeat 30 --label run_all,只打印不落盘。
想要可比较、可汇总的 JSON,请自己按 性能基准 一节跑。
检查清单
run_all.py 逐项运行的脚本,以及各自覆盖什么:
| 脚本 | 覆盖什么 |
|---|---|
check_engines.py |
引擎自检:颜色通道序(红/蓝不对称,抓 BGRA 与 RGB 搞反)、alpha 是否被正确保留、半透明彩色是否被正确解预乘、四条边的描边是否都画全 |
check_fidelity.py |
保真度:同一 spec 分别用 tksvg 参照与各栅格引擎渲染,逐像素比对,输出放大拼图与平均像素差 |
check_gallery.py |
设计稿画廊:取 tkflu.designs.button 的真实配色,渲染 24 个按钮状态(2 主题 × 3 样式 × 4 状态),逐引擎与 tksvg 比对 |
smoke_widgets.py |
全组件冒烟:在每个引擎下实例化 tkfluent 的全部组件,并强制跑一遍绘制 / 主题 / 悬停 / 按压事件 |
check_canvas_refs.py |
画布图片保活:同一画布画 5 张图后强制 GC,5 张必须都还在(验证"画面变空白"缺陷已修);以及 FluImage 能否正常构造 |
check_layout.py |
布局回归:把用户报过的"看得见的毛病"变成断言——菜单宽度容不容得下中文、底部按钮是否真被挤没、FluImage 是否真的画出图片、长文本是否被裁、内嵌 Entry/Text 是否挂在正确的主控件下 |
check_main.py |
命令行入口:--list-engines / --help / 非法引擎的退出码、resolve_renderer 各分支,以及逐引擎跑 --check |
check_docs.py |
文档站:构建 tkdeft 与 tkfluent 两个站点(mkdocs build --strict),把 nav 缺失、正文死链、docstring 解析失败挡在 CI 里 |
bench_render.py |
性能基准:各引擎端到端耗时(run_all.py --quick 不跑它) |
单独跑某一个检查
每个脚本都能独立运行,排查问题时很方便:
python benchmarks/check_engines.py        # 引擎通道序 / alpha / 描边
python benchmarks/check_fidelity.py       # 与 tksvg 逐像素比对(输出放大拼图)
python benchmarks/check_gallery.py        # 24 个按钮状态 × 各引擎
python benchmarks/check_canvas_refs.py    # 图片保活
python benchmarks/check_layout.py         # 布局断言
python benchmarks/check_main.py           # python -m tkflu 的入口与逐引擎自检
python benchmarks/check_docs.py           # 两个文档站

python benchmarks/check_docs.py tkdeft    # 只构建一个站
python benchmarks/smoke_widgets.py --engine skia --verbose   # 指定引擎 + 详细输出
两个会「跳过」而不是「失败」的检查
check_layout.py:必须在窗口真实映射的状态下测量——withdraw()时子控件 尺寸一律是1x1,什么都量不出来。因此没有桌面会话时它会跳过。check_docs.py:需要 mkdocs 工具链(pip install -r docs/requirements.txt), 未安装时跳过并提示。
性能基准
python benchmarks/bench_render.py --repeat 80 --renderer 2 --label skia
| 参数 | 说明 |
|---|---|
--renderer {0,1,2,3,4} |
指定引擎:0=tksvg(默认)1=wand 2=skia 3=pillow 4=cairo |
--repeat N |
每个测试项的重复次数(默认 40),取均值 / 中位数 / p95 |
--label NAME |
写进结果的标签,便于区分不同轮次的对比 |
--json PATH |
把结果写成 JSON;省略则只打印 |
--installed |
强制使用 site-packages 里的版本,用于测"未修改的基线" |
测量的 7 个路径:svg_gen(只生成 SVG 并落盘)、svg_raster(只把 SVG 栅格化)、
roundrect_vary(尺寸每帧不同 → 缓存必然 miss)、roundrect_same(参数一致 → 应命中缓存)、
button_draw(FluButton 完整一次 _draw)、button_hover(进入 + 离开,真实交互最高频路径)、
batch_20(20 个按钮批量重绘)。
本机最近一轮的结果:
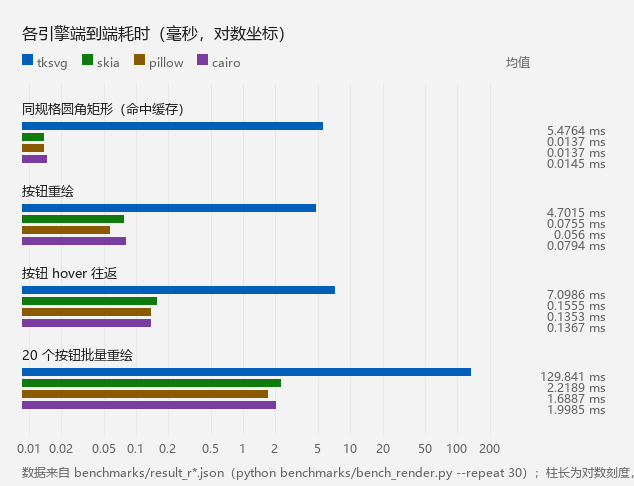
benchmarks/result_r*.json;柱长为对数刻度,用于比较量级。tksvg 是默认引擎,也是基准列汇总成对比表
# 各引擎各跑一轮,结果写进 benchmarks/ 下的约定文件名
python benchmarks/bench_render.py --renderer 0 --label tksvg  --json benchmarks/result_r0.json
python benchmarks/bench_render.py --renderer 2 --label skia   --json benchmarks/result_r2.json
python benchmarks/bench_render.py --renderer 3 --label pillow --json benchmarks/result_r3.json
python benchmarks/bench_render.py --renderer 4 --label cairo  --json benchmarks/result_r4.json

python benchmarks/report.py                  # 汇总并打印相对 tksvg 的加速比
report.py 固定读 benchmarks/result_r{0,2,3,4}.json,其中 result_r0.json(tksvg)
是基准列,缺了它就没法算加速比。
优化前后对比
python benchmarks/report_before_after.py
它读三份已提交的快照:result_before.json(优化前)、result_after_tksvg.json、
result_after_skia.json,打印出"优化前 → 仅修基础设施 → 换 skia 引擎"三列对比。
--installed 的基线只在特定前提下成立
--installed 会跳过仓库路径注入,让 import tkdeft / import tkfluent 命中
site-packages。但如果这两个包是 editable 安装的(本地开发默认就是),
site-packages 里的入口仍然指回仓库代码——此时它测的是"现状",不是"优化前"。
要拿到真正的基线,需要在 site-packages 里放一份非 editable 的旧版;
本仓库的做法是核对文件哈希后再跑,并把结果固化成 result_before.json。
视觉验证
性能数字说明"快",保真度数字说明"差多少像素",但仍要有人看一眼:
python benchmarks/visual_demo.py light skia     # 输出 benchmarks/_out/gallery_ui_light_skia.png
python benchmarks/visual_demo.py dark  pillow   # 输出 benchmarks/_out/gallery_ui_dark_pillow.png
它会真实显示整个组件画廊并截图。截图走 Win32 PrintWindow(按窗口句柄取内容),
而不是 PIL.ImageGrab——后者按屏幕坐标抓取,DPI 缩放 / 多虚拟桌面下经常抓到别的窗口。
原因与更多排查见 常见问题与排查。
两条方法论提醒
① 「测试全过」不等于用户在 IDE 里跑没问题
benchmarks/ 里的脚本(bench_render.py 的 _setup_path() 等)会主动把
仓库路径插到 sys.path 最前面,于是它们永远命中本地源码。
而真实场景——用户在 IDE 里点"运行"——不会插这个路径。
历史教训:site-packages 里是旧版 tkdeft 时,所有检查全绿,用户一运行就
ModuleNotFoundError: No module named 'tkdeft.engines'。
改完公共接口后,请另外用 python -m tkflu 或 IDE 直接跑一遍。
② 单次运行测不出状态泄漏
_default_root 残留、after 回调泄漏、Tcl 命令被重复删除——这些只有
在同一个进程里反复创建 / 销毁窗口才会暴露。
check_main.py 之所以要逐引擎跑 python -m tkflu --check,正是靠这一点
抓到了 after 回调泄漏导致的 TclError: can't delete Tcl command。
新增一个检查
三步,缺一不可:
- 在
benchmarks/放一个独立脚本,能用python benchmarks/你的脚本.py直接跑; 输出人类可读的结论,并把中间产物写到benchmarks/_out/。 - 在
run_all.py的检查清单里登记——STEPS列表里的(标题, 文件名, 是否属于基准);只有登记过的才会被一键回归跑到。 - 保证失败时返回非 0:
main()用return 1表示失败,并且用raise SystemExit(main())收尾。否则run_all.py会把它当成通过, 这个检查等于没写。
def main() -> int:
    ...
    if failures:
        for line in failures:
            print("失败:", line)
        return 1
    print("检查通过")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
可选的收尾:在 benchmarks/README.md 的表格里补一行;如果它面向使用者,
再在本页的 检查清单 里加一行。